Introdução
O Fairspec é uma norma aberta para a troca de dados FAIR, acompanhada do software que a implementa. Descreve o que um conjunto de dados contém, como são as suas tabelas, quem o produziu e sob que licença pode ser reutilizado — em JSON simples, que uma pessoa pode escrever à mão, um pipeline pode gerar e um job de CI pode validar.
Dica
Os princípios FAIR dizem que os dados devem ser localizáveis, acessíveis, interoperáveis e reutilizáveis. O Fairspec transforma esses princípios num formato de ficheiro com que uma máquina consegue trabalhar.
Porquê mais uma norma
Os conjuntos de dados são publicados constantemente e descritos de forma inconsistente. Os metadados que tornam um conjunto de dados reutilizável — tipos de coluna, unidades, proveniência, licença — costumam estar num README, num artigo ou na memória de alguém.
O Fairspec assenta deliberadamente em duas normas que já existem, em vez de competir com elas, e dá a cada uma um papel claro:
- Os metadados seguem o DataCite. Os metadados de citação de um conjunto de dados — títulos, autores, editor, licença, identificadores — usam o DataCite Metadata Schema 4.6, para que um conjunto de dados Fairspec traga os mesmos campos de que um repositório precisa para atribuir um DOI
- Os dados são descritos em JSON Schema. O Table Schema e o Data Schema, que descrevem as colunas de uma tabela e a estrutura de dados JSON, são compatíveis com o JSON Schema 2020-12, para que os JSON Schema que já usa para validar os seus dados funcionem no Fairspec sem alterações
Cinco especificações
A norma divide-se em cinco especificações pequenas, cada uma a descrever uma camada da publicação de dados:
- Dataset — um conjunto de dados e os seus recursos, com metadados compatíveis com DataCite e hashes de integridade
- Table Schema — colunas, tipos, restrições, chaves primárias e estrangeiras para dados tabulares
- Data Schema — a estrutura de dados JSON, compatível com JSON Schema
- File Dialect — como ler um ficheiro: CSV, TSV, JSON, JSONL, Parquet, Arrow, XLSX, ODS ou SQLite
- Catalog — um feed JSON Lines para sincronizar coleções de conjuntos de dados
Cada descritor aponta para um perfil versionado através de $schema, pelo que um validador sabe sempre que versão da norma está a ler:
{
  "$schema": "https://fairspec.org/profiles/latest/dataset.json",
  "titles": [{ "title": "Club members" }],
  "resources": [
    {
      "data": "members.csv",
      "tableSchema": {
        "primaryKey": ["id"],
        "properties": {
          "id": { "type": "integer" },
          "joined": { "type": "string", "format": "date" }
        }
      }
    }
  ]
}
Primeiro o software
Uma norma só é tão útil quanto as ferramentas que a implementam, por isso o Fairspec já as traz:
- Python —
pip install fairspec, construído sobre Polars DataFrames — documentação - TypeScript —
npm install fairspec, para Node, Deno, Bun e, para os metadados, o navegador — documentação - Rust — um único binário
fairspecpré-compilado, sem runtime para instalar — documentação - Servidor MCP — permite que um assistente de IA valide conjuntos de dados, infira esquemas e consulte tabelas — documentação
- Desktop — uma aplicação gráfica para macOS, Windows e Linux; os seus ficheiros nunca saem do seu computador — documentação
As bibliotecas de Python e TypeScript correm o mesmo conjunto partilhado de testes de conformidade, por isso um descritor válido numa é válido na outra.
Desempenho
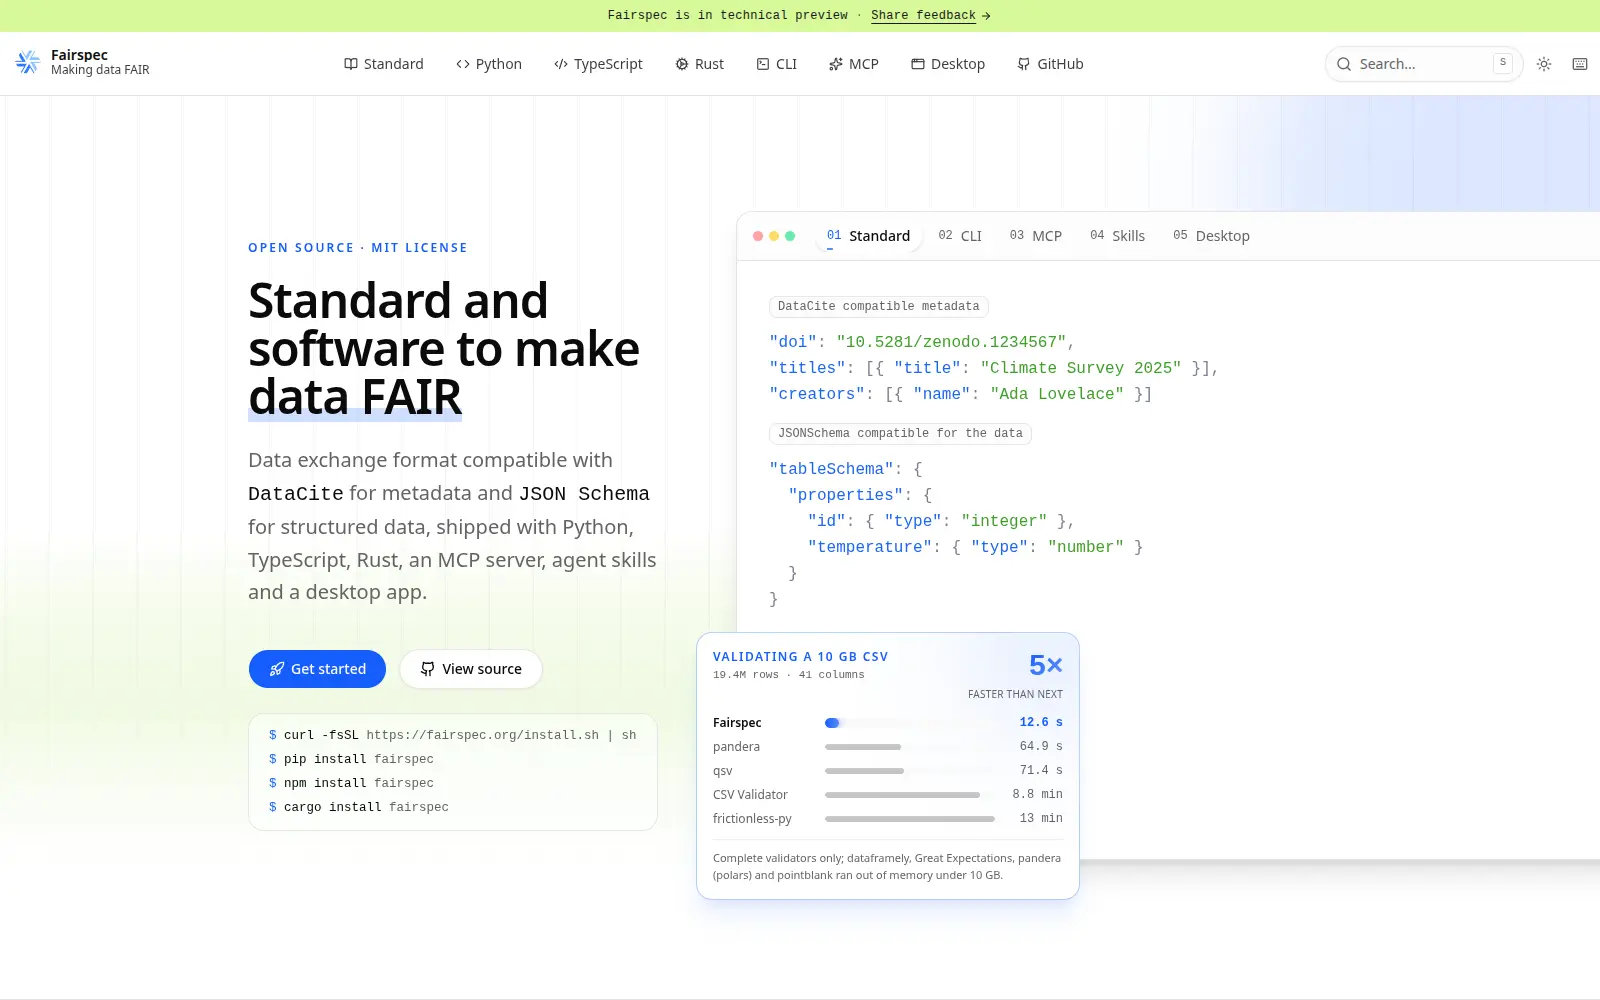
O Fairspec valida os dados com o Polars, o mesmo motor colunar nas três implementações. Medimo-lo a validar um CSV gerado de 10 GB (19,4 M de linhas, 41 colunas, 795 M de células) contra o seu Table Schema, ao lado de outros validadores completos — ferramentas que verificam cada célula e reportam cada uma que falha. Cada ferramenta tinha um limite de 10 GB de memória:
| Ferramenta | Tempo | Memória máxima |
|---|---|---|
| Fairspec (Rust) | 12.6 s | 1.0 GB |
| Fairspec (Python) | 12.6 s | 1.0 GB |
| Fairspec (TypeScript) | 15.5 s | 1.6 GB |
| pandera (DuckDB) | 1 min 5 s | 6.3 GB |
| qsv | 1 min 11 s | 3.8 GB |
| CSV Validator | 8 min 50 s | 3.2 GB |
| frictionless-py | 13 min 8 s | 2.8 GB |
É cerca de 5× mais rápido do que o rival mais rápido. dataframely, Great Expectations, pandera (polars) e pointblank ficaram sem memória antes de terminar. Medido a 2026-10-28 num AMD Ryzen 5 PRO 7545U com 32 GB de RAM; o benchmark está no repositório, por isso pode corrê-lo você mesmo.
Experimentar no terminal
Todos os pacotes trazem o mesmo comando fairspec. Infira um esquema a partir de um ficheiro CSV, valide o ficheiro contra ele e consulte-o com SQL:
fairspec table infer-schema members.csv --json > schema.json
fairspec table validate members.csv --schema schema.json
fairspec table query members.csv "SELECT name, score FROM self WHERE score > 80"
Em macOS e Linux, o binário pré-compilado está à distância de um comando:
curl -fsSL https://fairspec.org/install.sh | shPara dar as mesmas capacidades a um assistente de IA, acrescente o servidor MCP à sua configuração:
{
  "mcpServers": {
    "fairspec": {
      "command": "npx",
      "args": ["fairspec@latest", "mcp"]
    }
  }
}
Próximos passos
O Fairspec está em desenvolvimento ativo e é open source sob a licença MIT. Procuramos opiniões de quem publica, cuida ou utiliza dados de investigação. Experimente-o, abra uma issue e dê-lhe uma estrela no GitHub para ajudar o projeto a crescer — https://github.com/datisthq/fairspec