Introduzione
Fairspec è uno standard aperto per lo scambio di dati FAIR, insieme al software che lo implementa. Descrive cosa contiene un dataset, com'è fatta ogni sua tabella, chi lo ha prodotto e con quale licenza può essere riutilizzato — in semplice JSON, che una persona può scrivere a mano, una pipeline può generare e un job di CI può validare.
Suggerimento
I principi FAIR dicono che i dati devono essere reperibili, accessibili, interoperabili e riutilizzabili. Fairspec trasforma questi principi in un formato di file su cui una macchina può agire.
Perché un altro standard
I dataset vengono pubblicati di continuo e descritti in modo incoerente. I metadati che rendono un dataset riutilizzabile — tipi di colonna, unità, provenienza, licenza — di solito stanno in un README, in un articolo o nella memoria di qualcuno.
Fairspec si basa deliberatamente su due standard già esistenti invece di farvi concorrenza, e assegna a ciascuno un compito preciso:
- I metadati seguono DataCite. I metadati di citazione di un dataset — titoli, autori, editore, licenza, identificatori — usano il DataCite Metadata Schema 4.6, così un dataset Fairspec porta gli stessi campi di cui un repository ha bisogno per assegnare un DOI
- I dati sono descritti in JSON Schema. Table Schema e Data Schema, che descrivono le colonne di una tabella e la struttura dei dati JSON, sono compatibili con JSON Schema 2020-12, così i JSON Schema che già usi per validare i tuoi dati funzionano in Fairspec senza modifiche
Cinque specifiche
Lo standard è suddiviso in cinque piccole specifiche, ognuna delle quali descrive un livello della pubblicazione dei dati:
- Dataset — un dataset e le sue risorse, con metadati compatibili con DataCite e hash di integrità
- Table Schema — colonne, tipi, vincoli, chiavi primarie ed esterne per i dati tabellari
- Data Schema — la struttura dei dati JSON, compatibile con JSON Schema
- File Dialect — come leggere un file: CSV, TSV, JSON, JSONL, Parquet, Arrow, XLSX, ODS o SQLite
- Catalog — un feed JSON Lines per sincronizzare raccolte di dataset
Ogni descrittore punta a un profilo versionato tramite $schema, così un validatore sa sempre quale versione dello standard sta leggendo:
{
  "$schema": "https://fairspec.org/profiles/latest/dataset.json",
  "titles": [{ "title": "Club members" }],
  "resources": [
    {
      "data": "members.csv",
      "tableSchema": {
        "primaryKey": ["id"],
        "properties": {
          "id": { "type": "integer" },
          "joined": { "type": "string", "format": "date" }
        }
      }
    }
  ]
}
Prima il software
Uno standard è utile quanto gli strumenti che lo implementano, per questo Fairspec li include:
- Python —
pip install fairspec, basato su Polars DataFrames — documentazione - TypeScript —
npm install fairspec, per Node, Deno, Bun e, per i metadati, il browser — documentazione - Rust — un unico binario
fairspecprecompilato, senza runtime da installare — documentazione - Server MCP — permette a un assistente IA di validare dataset, inferire schemi e interrogare tabelle — documentazione
- Desktop — un'applicazione grafica per macOS, Windows e Linux; i tuoi file non lasciano mai il tuo computer — documentazione
Le librerie Python e TypeScript eseguono la stessa suite di conformità condivisa, quindi un descrittore valido nell'una è valido anche nell'altra.
Prestazioni
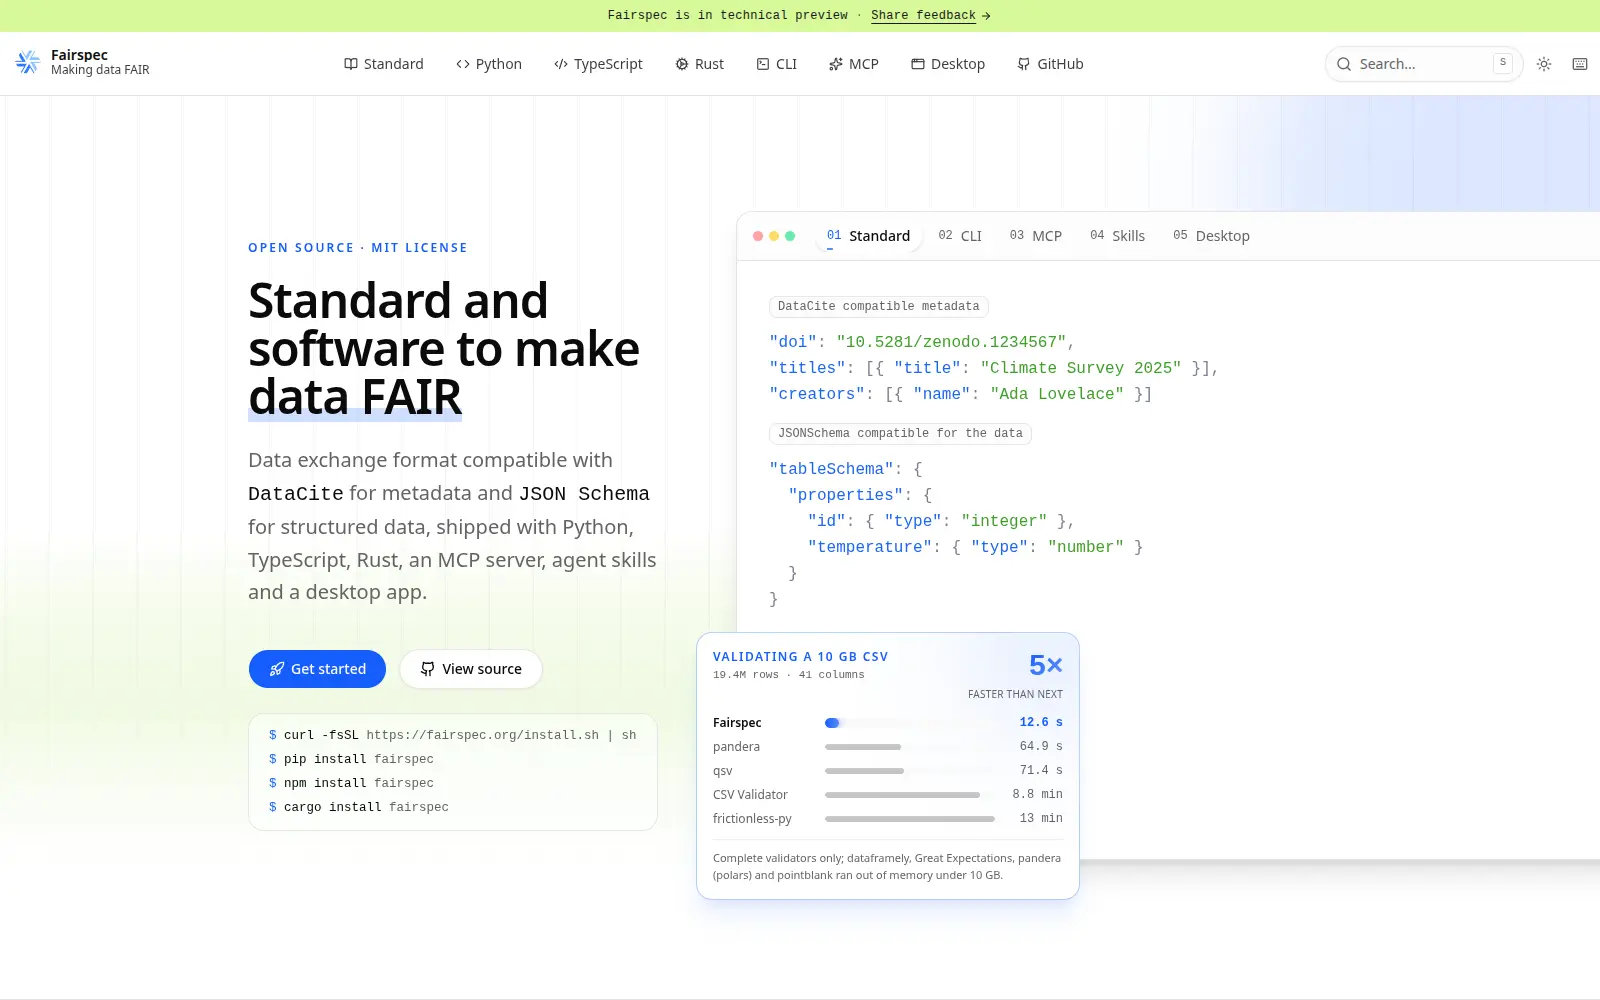
Fairspec valida i dati con Polars, lo stesso motore colonnare in tutte e tre le implementazioni. Lo abbiamo misurato mentre validava un CSV generato da 10 GB (19,4 M di righe, 41 colonne, 795 M di celle) rispetto al suo Table Schema, accanto ad altri validatori completi — strumenti che controllano ogni cella e segnalano ciascuna di quelle non valide. Ogni strumento aveva un limite di 10 GB di memoria:
| Strumento | Tempo | Memoria massima |
|---|---|---|
| Fairspec (Rust) | 12.6 s | 1.0 GB |
| Fairspec (Python) | 12.6 s | 1.0 GB |
| Fairspec (TypeScript) | 15.5 s | 1.6 GB |
| pandera (DuckDB) | 1 min 5 s | 6.3 GB |
| qsv | 1 min 11 s | 3.8 GB |
| CSV Validator | 8 min 50 s | 3.2 GB |
| frictionless-py | 13 min 8 s | 2.8 GB |
È circa 5× più veloce del rivale più rapido. dataframely, Great Expectations, pandera (polars) e pointblank hanno esaurito la memoria prima di finire. Misurato il 2026-10-28 su un AMD Ryzen 5 PRO 7545U con 32 GB di RAM; il benchmark è nel repository, quindi puoi eseguirlo tu stesso.
Provarlo dal terminale
Ogni pacchetto fornisce lo stesso comando fairspec. Inferisci uno schema da un file CSV, valida il file rispetto a esso e interrogalo con SQL:
fairspec table infer-schema members.csv --json > schema.json
fairspec table validate members.csv --schema schema.json
fairspec table query members.csv "SELECT name, score FROM self WHERE score > 80"
Su macOS e Linux, il binario precompilato è a un solo comando di distanza:
curl -fsSL https://fairspec.org/install.sh | shPer dare le stesse capacità a un assistente IA, aggiungi il server MCP alla sua configurazione:
{
  "mcpServers": {
    "fairspec": {
      "command": "npx",
      "args": ["fairspec@latest", "mcp"]
    }
  }
}
Prossimi passi
Fairspec è in sviluppo attivo ed è open source con licenza MIT. Cerchiamo il parere di chiunque pubblichi, curi o utilizzi dati di ricerca. Provalo, apri una issue e lascia una stella su GitHub per aiutare il progetto a crescere — https://github.com/datisthq/fairspec