Introduction
Fairspec est un standard ouvert d’échange de données FAIR, accompagné du logiciel qui l’implémente. Il décrit ce que contient un jeu de données, la forme de ses tables, qui l’a produit et sous quelle licence il peut être réutilisé — en JSON simple, qu’une personne peut écrire à la main, qu’un pipeline peut générer et qu’un job de CI peut valider.
Astuce
Les principes FAIR disent que les données doivent être faciles à trouver, accessibles, interopérables et réutilisables. Fairspec transforme ces principes en un format de fichier exploitable par une machine.
Pourquoi un standard de plus
Les jeux de données sont publiés en permanence et décrits de façon incohérente. Les métadonnées qui rendent un jeu de données réutilisable — types de colonnes, unités, provenance, licence — se trouvent généralement dans un README, un article ou la mémoire de quelqu’un.
Fairspec s’appuie délibérément sur deux standards existants plutôt que de les concurrencer, et confie à chacun un rôle précis :
- Les métadonnées suivent DataCite. Les métadonnées de citation d’un jeu de données — titres, créateurs, éditeur, licence, identifiants — utilisent DataCite Metadata Schema 4.6, afin qu’un jeu de données Fairspec porte les mêmes champs qu’un entrepôt utilise pour attribuer un DOI
- Les données sont décrites en JSON Schema. Table Schema et Data Schema, qui décrivent les colonnes d’une table et la structure des données JSON, sont compatibles avec JSON Schema 2020-12, afin que les JSON Schema que vous utilisez déjà pour valider vos données fonctionnent tels quels dans Fairspec
Cinq spécifications
Le standard se compose de cinq petites spécifications, chacune décrivant une couche de la publication de données :
- Dataset — un jeu de données et ses ressources, avec des métadonnées compatibles DataCite et des empreintes d’intégrité
- Table Schema — colonnes, types, contraintes, clés primaires et étrangères pour les données tabulaires
- Data Schema — la structure des données JSON, compatible avec JSON Schema
- File Dialect — comment lire un fichier : CSV, TSV, JSON, JSONL, Parquet, Arrow, XLSX, ODS ou SQLite
- Catalog — un flux JSON Lines pour synchroniser des collections de jeux de données
Chaque descripteur pointe vers un profil versionné via $schema, si bien qu’un validateur sait toujours quelle version du standard il lit :
{
  "$schema": "https://fairspec.org/profiles/latest/dataset.json",
  "titles": [{ "title": "Club members" }],
  "resources": [
    {
      "data": "members.csv",
      "tableSchema": {
        "primaryKey": ["id"],
        "properties": {
          "id": { "type": "integer" },
          "joined": { "type": "string", "format": "date" }
        }
      }
    }
  ]
}
Le logiciel d’abord
Un standard ne vaut que par les outils qui l’implémentent, c’est pourquoi Fairspec les fournit :
- Python —
pip install fairspec, construit sur Polars DataFrames — docs - TypeScript —
npm install fairspec, pour Node, Deno, Bun et, pour les métadonnées, le navigateur — docs - Rust — un unique binaire
fairspecprécompilé, sans runtime à installer — docs - Serveur MCP — permet à un assistant IA de valider des jeux de données, d’inférer des schémas et d’interroger des tables — docs
- Desktop — une application graphique pour macOS, Windows et Linux ; vos fichiers ne quittent jamais votre machine — docs
Les bibliothèques Python et TypeScript passent la même suite de conformité partagée : un descripteur valide dans l’une est valide dans l’autre.
Performances
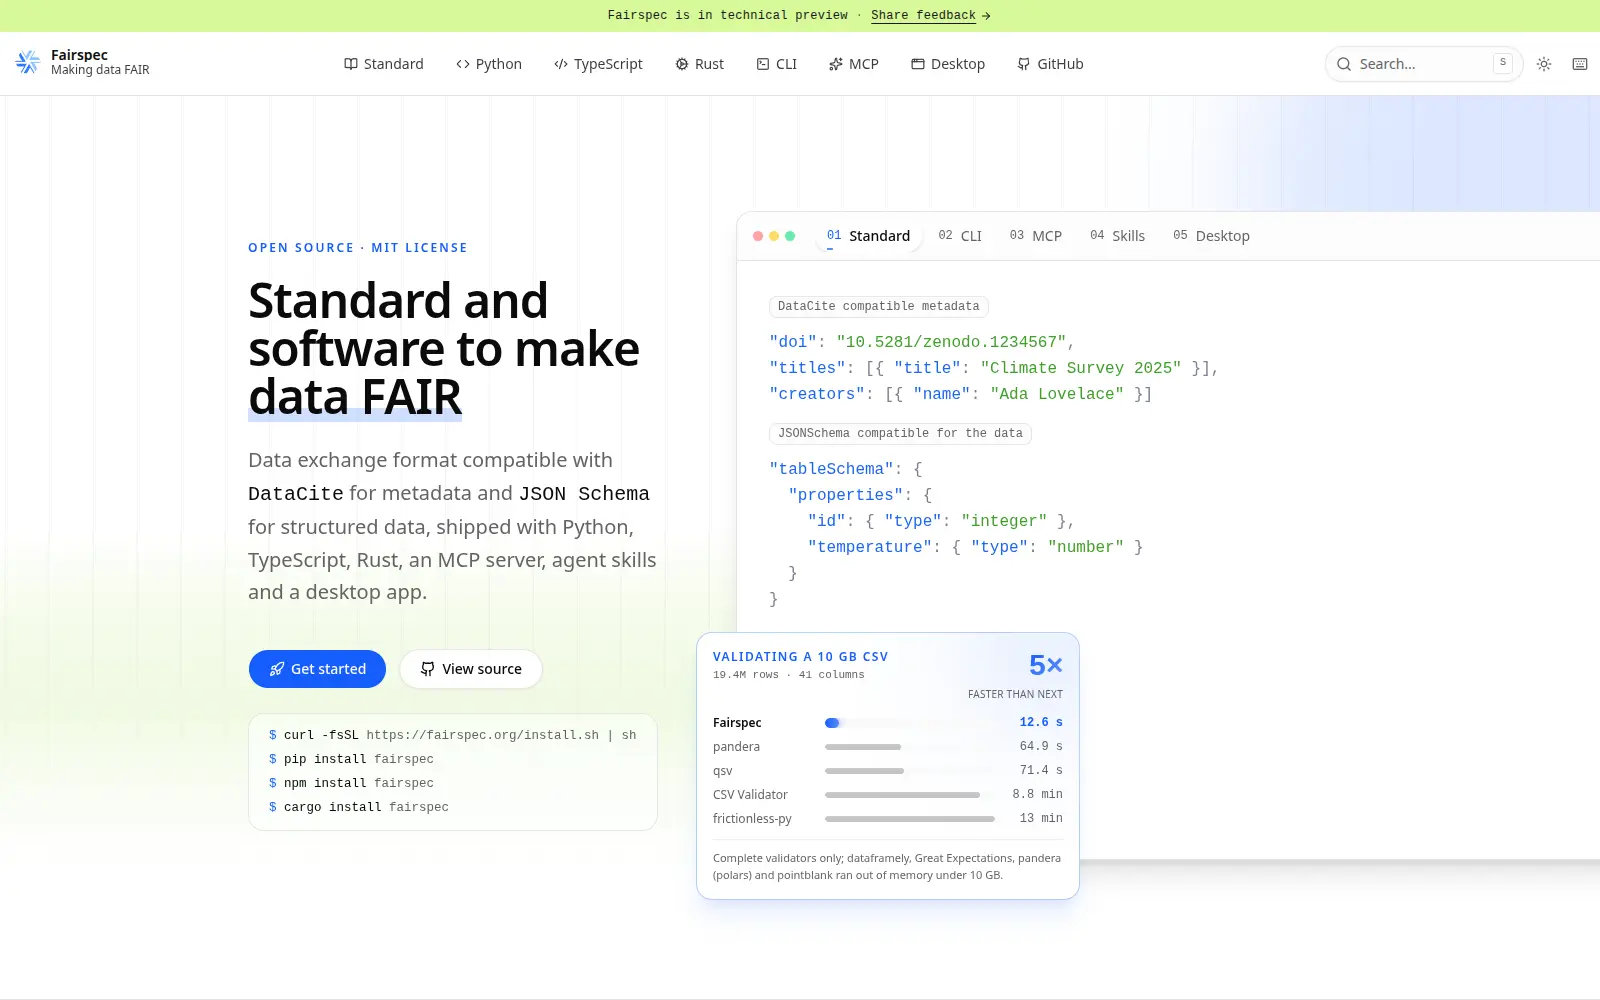
Fairspec valide les données avec Polars, le même moteur en colonnes dans les trois implémentations. Nous l’avons mesuré en validant un CSV généré de 10 Go (19,4 M de lignes, 41 colonnes, 795 M de cellules) contre son Table Schema, aux côtés d’autres validateurs complets — des outils qui vérifient chaque cellule et signalent chacune de celles qui échouent. Chaque outil était limité à 10 Go de mémoire :
| Outil | Durée | Mémoire maximale |
|---|---|---|
| Fairspec (Rust) | 12.6 s | 1.0 GB |
| Fairspec (Python) | 12.6 s | 1.0 GB |
| Fairspec (TypeScript) | 15.5 s | 1.6 GB |
| pandera (DuckDB) | 1 min 5 s | 6.3 GB |
| qsv | 1 min 11 s | 3.8 GB |
| CSV Validator | 8 min 50 s | 3.2 GB |
| frictionless-py | 13 min 8 s | 2.8 GB |
C’est environ 5× plus rapide que le concurrent le plus rapide. dataframely, Great Expectations, pandera (polars) et pointblank ont manqué de mémoire avant la fin. Mesuré le 2026-10-28 sur un AMD Ryzen 5 PRO 7545U avec 32 Go de RAM ; le benchmark se trouve dans le dépôt, vous pouvez donc le lancer vous-même.
L’essayer dans le terminal
Chaque paquet fournit la même commande fairspec. Inférez un schéma à partir d’un fichier CSV, validez le fichier contre ce schéma et interrogez-le en SQL :
fairspec table infer-schema members.csv --json > schema.json
fairspec table validate members.csv --schema schema.json
fairspec table query members.csv "SELECT name, score FROM self WHERE score > 80"
Sous macOS et Linux, le binaire précompilé s’installe en une commande :
curl -fsSL https://fairspec.org/install.sh | shPour donner les mêmes capacités à un assistant IA, ajoutez le serveur MCP à sa configuration :
{
  "mcpServers": {
    "fairspec": {
      "command": "npx",
      "args": ["fairspec@latest", "mcp"]
    }
  }
}
La suite
Fairspec est en développement actif et open source sous licence MIT. Nous attendons les retours de toutes celles et ceux qui publient, organisent ou utilisent des données de recherche. Essayez-le, ouvrez une issue et ajoutez une étoile sur GitHub pour aider le projet à grandir — https://github.com/datisthq/fairspec