Introducción
Fairspec es un estándar abierto para intercambiar datos FAIR, junto con el software que lo implementa. Describe qué contiene un conjunto de datos, cómo son sus tablas, quién lo produjo y bajo qué licencia puede reutilizarse, en JSON sencillo que una persona puede escribir a mano, un pipeline puede generar y un job de CI puede validar.
Consejo
Los principios FAIR dicen que los datos deben ser localizables, accesibles, interoperables y reutilizables. Fairspec convierte esos principios en un formato de archivo con el que una máquina puede trabajar.
Por qué otro estándar
Los conjuntos de datos se publican constantemente y se describen de forma inconsistente. Los metadatos que hacen reutilizable un conjunto de datos —tipos de columna, unidades, procedencia, licencia— suelen estar en un README, en un artículo o en la memoria de alguien.
Fairspec se apoya deliberadamente en dos estándares que ya existen en lugar de competir con ellos, y da a cada uno una función clara:
- Los metadatos siguen DataCite. Los metadatos de citación de un conjunto de datos —títulos, autores, editor, licencia, identificadores— usan DataCite Metadata Schema 4.6, de modo que un conjunto de datos Fairspec lleva los mismos campos que un repositorio necesita para asignar un DOI
- Los datos se describen en JSON Schema. Table Schema y Data Schema, que describen las columnas de una tabla y la estructura de los datos JSON, son compatibles con JSON Schema 2020-12, de modo que los JSON Schema que ya usas para validar tus datos funcionan en Fairspec sin cambios
Cinco especificaciones
El estándar se divide en cinco especificaciones pequeñas, cada una de las cuales describe una capa de la publicación de datos:
- Dataset — un conjunto de datos y sus recursos, con metadatos compatibles con DataCite y hashes de integridad
- Table Schema — columnas, tipos, restricciones, claves primarias y foráneas para datos tabulares
- Data Schema — la estructura de datos JSON, compatible con JSON Schema
- File Dialect — cómo leer un archivo: CSV, TSV, JSON, JSONL, Parquet, Arrow, XLSX, ODS o SQLite
- Catalog — un feed JSON Lines para sincronizar colecciones de conjuntos de datos
Cada descriptor apunta a un perfil versionado mediante $schema, así un validador siempre sabe qué versión del estándar está leyendo:
{
  "$schema": "https://fairspec.org/profiles/latest/dataset.json",
  "titles": [{ "title": "Club members" }],
  "resources": [
    {
      "data": "members.csv",
      "tableSchema": {
        "primaryKey": ["id"],
        "properties": {
          "id": { "type": "integer" },
          "joined": { "type": "string", "format": "date" }
        }
      }
    }
  ]
}
Primero el software
Un estándar es tan útil como las herramientas que lo implementan, por eso Fairspec viene con ellas:
- Python —
pip install fairspec, construido sobre Polars DataFrames — docs - TypeScript —
npm install fairspec, para Node, Deno, Bun y, para los metadatos, el navegador — docs - Rust — un único binario
fairspecprecompilado, sin runtime que instalar — docs - Servidor MCP — permite que un asistente de IA valide conjuntos de datos, infiera esquemas y consulte tablas — docs
- Escritorio — una aplicación visual para macOS, Windows y Linux; tus archivos nunca salen de tu equipo — docs
Las bibliotecas de Python y TypeScript ejecutan una misma suite de conformidad compartida, así que un descriptor válido en una es válido en la otra.
Rendimiento
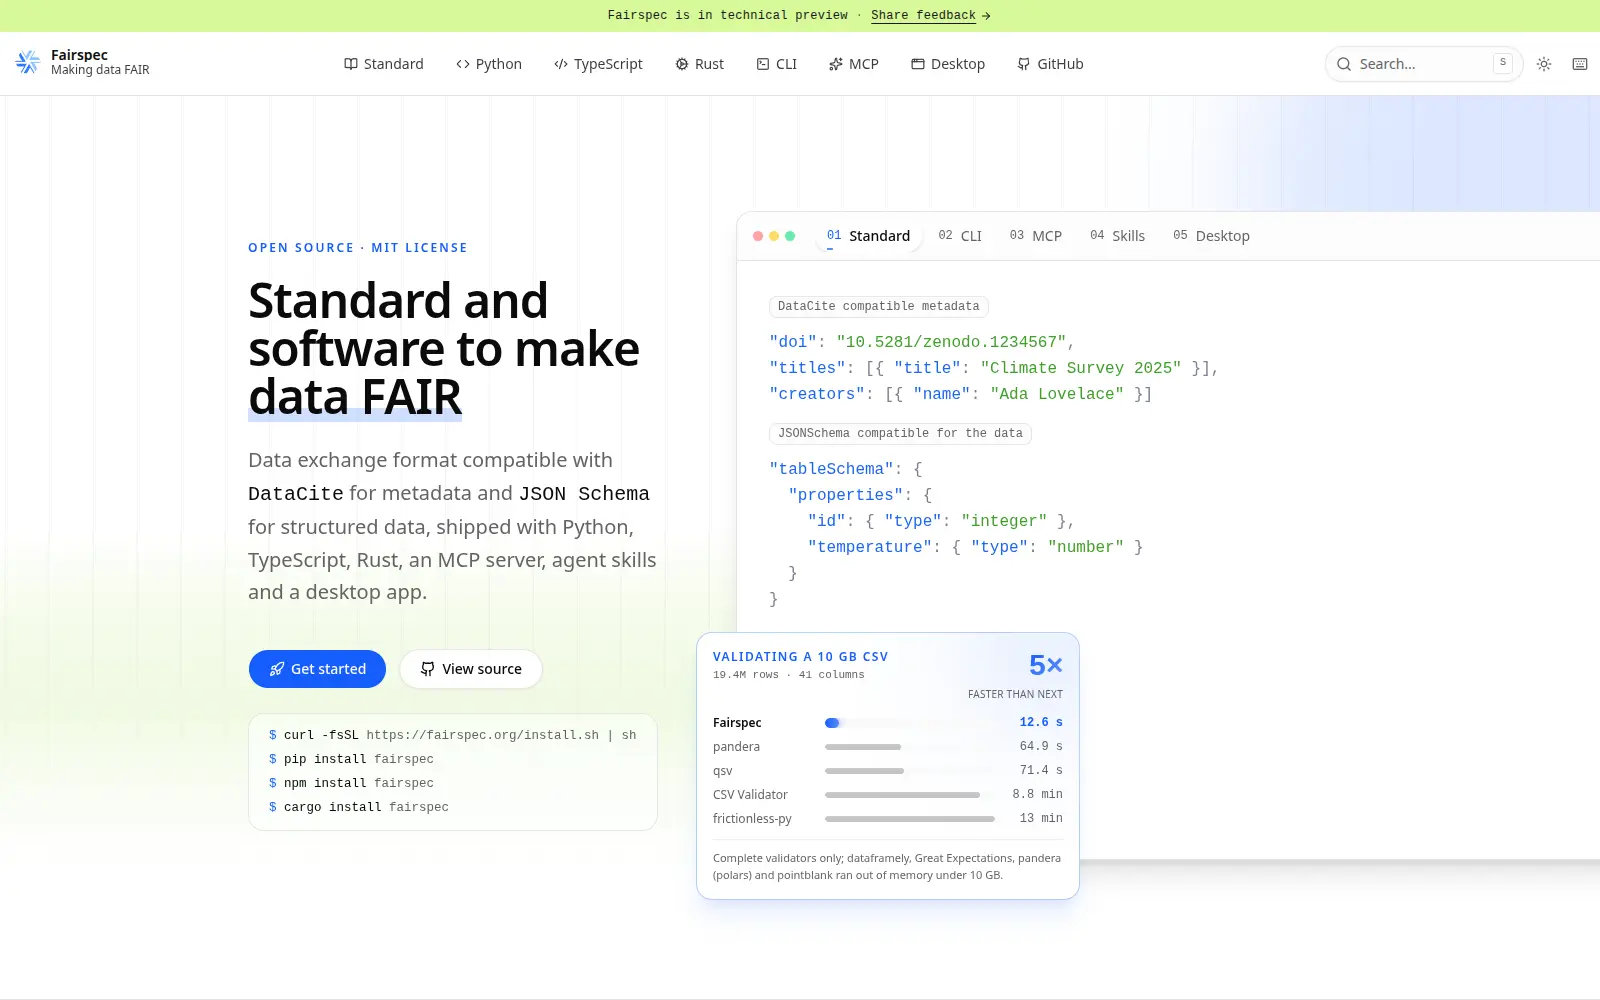
Fairspec valida los datos con Polars, el mismo motor columnar en las tres implementaciones. Lo medimos validando un CSV generado de 10 GB (19,4 M de filas, 41 columnas, 795 M de celdas) contra su Table Schema, junto a otros validadores completos: herramientas que comprueban cada celda e informan de cada una que falla. Cada herramienta tenía un límite de 10 GB de memoria:
| Herramienta | Tiempo | Memoria máxima |
|---|---|---|
| Fairspec (Rust) | 12.6 s | 1.0 GB |
| Fairspec (Python) | 12.6 s | 1.0 GB |
| Fairspec (TypeScript) | 15.5 s | 1.6 GB |
| pandera (DuckDB) | 1 min 5 s | 6.3 GB |
| qsv | 1 min 11 s | 3.8 GB |
| CSV Validator | 8 min 50 s | 3.2 GB |
| frictionless-py | 13 min 8 s | 2.8 GB |
Es unas 5× más rápido que el rival más rápido. dataframely, Great Expectations, pandera (polars) y pointblank se quedaron sin memoria antes de terminar. Medido el 2026-10-28 en un AMD Ryzen 5 PRO 7545U con 32 GB de RAM; el benchmark está en el repositorio, así que puedes ejecutarlo tú mismo.
Probarlo desde la terminal
Todos los paquetes incluyen el mismo comando fairspec. Infiere un esquema a partir de un archivo CSV, valida el archivo contra él y consúltalo con SQL:
fairspec table infer-schema members.csv --json > schema.json
fairspec table validate members.csv --schema schema.json
fairspec table query members.csv "SELECT name, score FROM self WHERE score > 80"
En macOS y Linux, el binario precompilado está a un solo comando:
curl -fsSL https://fairspec.org/install.sh | shPara dar las mismas capacidades a un asistente de IA, añade el servidor MCP a su configuración:
{
  "mcpServers": {
    "fairspec": {
      "command": "npx",
      "args": ["fairspec@latest", "mcp"]
    }
  }
}
Próximos pasos
Fairspec está en desarrollo activo y es de código abierto bajo la licencia MIT. Buscamos opiniones de cualquiera que publique, cure o utilice datos de investigación. Pruébalo, abre un issue y dale una estrella en GitHub para ayudar a que el proyecto crezca: https://github.com/datisthq/fairspec