Einführung
Fairspec ist ein offener Standard für den Austausch von FAIR-Daten, zusammen mit der Software, die ihn implementiert. Er beschreibt, was ein Datensatz enthält, wie seine Tabellen aufgebaut sind, wer ihn erstellt hat und unter welcher Lizenz er wiederverwendet werden darf — in einfachem JSON, das ein Mensch von Hand schreiben, eine Pipeline erzeugen und ein CI-Job validieren kann.
Tipp
Die FAIR-Prinzipien besagen, dass Daten auffindbar, zugänglich, interoperabel und wiederverwendbar sein sollen. Fairspec macht aus diesen Prinzipien ein Dateiformat, mit dem eine Maschine arbeiten kann.
Warum noch ein Standard
Datensätze werden ständig veröffentlicht und uneinheitlich beschrieben. Die Metadaten, die einen Datensatz wiederverwendbar machen — Spaltentypen, Einheiten, Herkunft, Lizenz — stehen meist in einer README, einem Paper oder in jemandes Gedächtnis.
Fairspec baut bewusst auf zwei bestehenden Standards auf, statt mit ihnen zu konkurrieren, und gibt jedem eine klare Aufgabe:
- Metadaten folgen DataCite. Die Zitationsmetadaten eines Datensatzes — Titel, Urheber, Herausgeber, Lizenz, Identifikatoren — nutzen das DataCite Metadata Schema 4.6, sodass ein Fairspec-Datensatz dieselben Felder trägt, die ein Repositorium zur Vergabe einer DOI braucht
- Daten werden in JSON Schema beschrieben. Table Schema und Data Schema, die die Spalten einer Tabelle und die Struktur von JSON-Daten beschreiben, sind mit JSON Schema 2020-12 kompatibel, sodass die JSON Schemas, mit denen Sie Ihre Daten bereits validieren, in Fairspec ohne Anpassung funktionieren
Fünf Spezifikationen
Der Standard besteht aus fünf kleinen Spezifikationen, die jeweils eine Ebene der Datenveröffentlichung beschreiben:
- Dataset — ein Datensatz und seine Ressourcen, mit DataCite-kompatiblen Metadaten und Integritäts-Hashes
- Table Schema — Spalten, Typen, Constraints, Primär- und Fremdschlüssel für tabellarische Daten
- Data Schema — die Struktur von JSON-Daten, kompatibel mit JSON Schema
- File Dialect — wie eine Datei zu lesen ist: CSV, TSV, JSON, JSONL, Parquet, Arrow, XLSX, ODS oder SQLite
- Catalog — ein JSON-Lines-Feed zum Synchronisieren von Sammlungen von Datensätzen
Jeder Deskriptor verweist über $schema auf ein versioniertes Profil, sodass ein Validator immer weiß, welche Version des Standards er liest:
{
  "$schema": "https://fairspec.org/profiles/latest/dataset.json",
  "titles": [{ "title": "Club members" }],
  "resources": [
    {
      "data": "members.csv",
      "tableSchema": {
        "primaryKey": ["id"],
        "properties": {
          "id": { "type": "integer" },
          "joined": { "type": "string", "format": "date" }
        }
      }
    }
  ]
}
Software zuerst
Ein Standard ist nur so nützlich wie die Werkzeuge, die ihn implementieren, deshalb bringt Fairspec sie gleich mit:
- Python —
pip install fairspec, auf Basis von Polars DataFrames — Doku - TypeScript —
npm install fairspec, für Node, Deno, Bun und, für Metadaten, den Browser — Doku - Rust — eine einzige vorkompilierte
fairspec-Binary ohne zu installierende Laufzeitumgebung — Doku - MCP-Server — lässt einen KI-Assistenten Datensätze validieren, Schemas ableiten und Tabellen abfragen — Doku
- Desktop — eine grafische Anwendung für macOS, Windows und Linux; Ihre Dateien verlassen Ihren Rechner nie — Doku
Die Python- und die TypeScript-Bibliothek durchlaufen dieselbe gemeinsame Konformitäts-Testsuite, sodass ein Deskriptor, der in der einen gültig ist, auch in der anderen gültig ist.
Performance
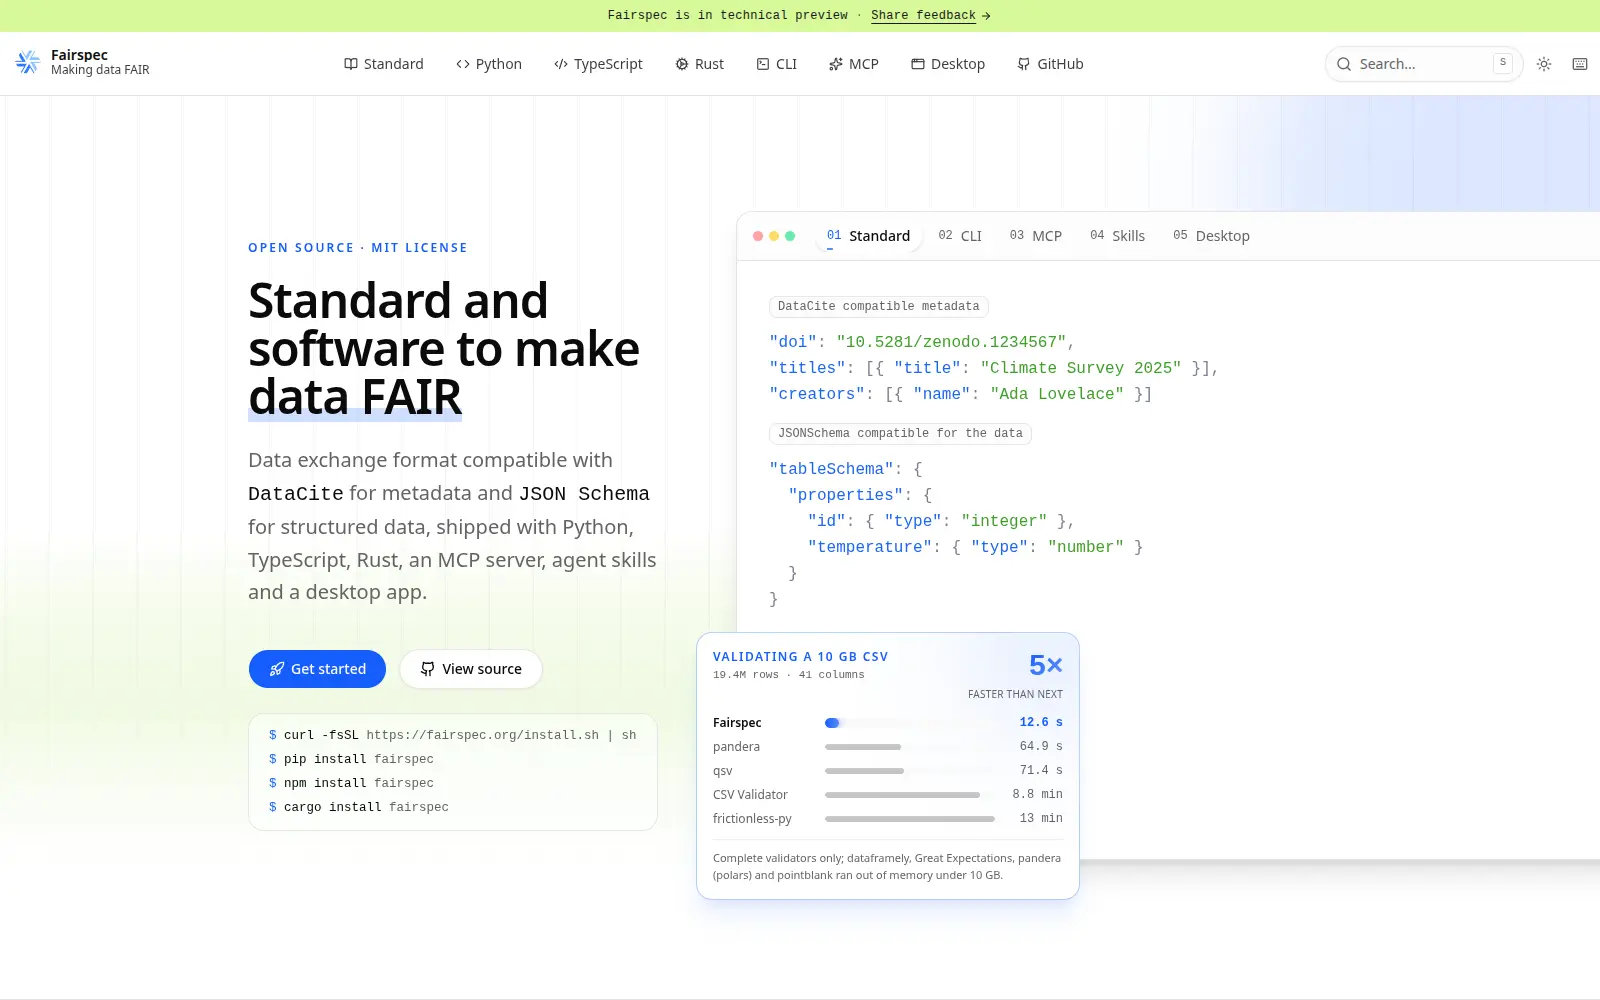
Fairspec validiert Daten mit Polars, derselben spaltenorientierten Engine in allen drei Implementierungen. Wir haben gemessen, wie es eine generierte 10-GB-CSV-Datei (19,4 Mio. Zeilen, 41 Spalten, 795 Mio. Zellen) gegen ihr Table Schema validiert, neben anderen vollständigen Validatoren — Werkzeugen, die jede Zelle prüfen und jede fehlerhafte melden. Jedes Werkzeug war auf 10 GB Arbeitsspeicher begrenzt:
| Werkzeug | Zeit | Spitzenspeicher |
|---|---|---|
| Fairspec (Rust) | 12.6 s | 1.0 GB |
| Fairspec (Python) | 12.6 s | 1.0 GB |
| Fairspec (TypeScript) | 15.5 s | 1.6 GB |
| pandera (DuckDB) | 1 min 5 s | 6.3 GB |
| qsv | 1 min 11 s | 3.8 GB |
| CSV Validator | 8 min 50 s | 3.2 GB |
| frictionless-py | 13 min 8 s | 2.8 GB |
Das ist etwa 5× schneller als der schnellste Konkurrent. dataframely, Great Expectations, pandera (polars) und pointblank liefen vor dem Ende in Speichermangel. Gemessen am 2026-10-28 auf einem AMD Ryzen 5 PRO 7545U mit 32 GB RAM; der Benchmark liegt im Repository, sodass Sie ihn selbst ausführen können.
Ausprobieren im Terminal
Jedes Paket liefert denselben fairspec-Befehl. Leiten Sie ein Schema aus einer CSV-Datei ab, validieren Sie die Datei dagegen und fragen Sie sie mit SQL ab:
fairspec table infer-schema members.csv --json > schema.json
fairspec table validate members.csv --schema schema.json
fairspec table query members.csv "SELECT name, score FROM self WHERE score > 80"
Unter macOS und Linux ist die vorkompilierte Binary nur einen Befehl entfernt:
curl -fsSL https://fairspec.org/install.sh | shUm einem KI-Assistenten dieselben Fähigkeiten zu geben, fügen Sie den MCP-Server zu seiner Konfiguration hinzu:
{
  "mcpServers": {
    "fairspec": {
      "command": "npx",
      "args": ["fairspec@latest", "mcp"]
    }
  }
}
Wie es weitergeht
Fairspec wird aktiv entwickelt und ist Open Source unter der MIT-Lizenz. Wir freuen uns über Feedback von allen, die Forschungsdaten veröffentlichen, kuratieren oder nutzen. Probieren Sie es aus, eröffnen Sie ein Issue und geben Sie dem Projekt einen Stern auf GitHub, damit es wachsen kann — https://github.com/datisthq/fairspec